Declaración RGPD de flujos de datos
Relaciones con modelos de lenguaje de gran tamaño externos
Descripción fáctica, derivada del código, de cada vía por la que los datos salen de
IRONSTICK hacia un LLM externo, de qué se transmite exactamente, en qué forma y
dónde se aplica la capa de seudonimización. Edición de escritorio para Windows. El presente documento
describe únicamente el comportamiento de IRONSTICK — lo que el proveedor de IA hace con los datos
recibidos se rige exclusivamente por las condiciones propias del proveedor (las condiciones y
políticas de privacidad de los proveedores que el usuario haya configurado: Alibaba Cloud (Qwen),
Moonshot AI (Kimi), OpenAI, Anthropic y, si se han activado, Groq, OpenRouter y
Mistral; Google solo si se utiliza Google Drive para exportaciones), que el
usuario debe revisar por separado.
Versión 1.0.7 — a noviembre de 2026
Resumen.
- Almacenamiento. Todos los datos residen en un único directorio de datos local. La base de datos,
el almacén de documentos, el archivo de configuración y el almacén temporal de IA están cifrados con AES-256
en reposo. Permanecen en texto claro únicamente las copias de trabajo temporales de los documentos abiertos,
la bandeja de entrada de escaneos, las exportaciones y los archivos salientes, el búfer de revisión por pares
de corta duración y, si se ha activado, el registro de diagnóstico (sección 8).
- IA externa. Las llamadas de IA dentro de la aplicación existen únicamente con la propia clave API del usuario.
Las llamadas a través del router central se seudonimizan de forma predeterminada y se anotan en un
registro de auditoría local; las excepciones deliberadas en texto claro se enumeran en 2.3.
- Consentimiento. El chat de IA, el registro de documentos y la investigación de personas piden consentimiento una vez
por sesión o por ejecución del programa; en el procesador de textos, iniciar una función de IA constituye
el consentimiento. Varias funciones en segundo plano llaman a la IA en la nube sin cuadro de diálogo propio:
la clasificación de correo electrónico, el Monitor de coherencia de datos, el informe diario, el resumen del diálogo
y la revisión Red/Blue Team (sección 3).
- Bridge de IA de escritorio. Un complemento opcional que transmite datos reales de expedientes al proveedor de la propia IA de escritorio del usuario, tras
un cuadro de diálogo de consentimiento por ejecución del programa (sección 4.9).
- Otros servicios. Las direcciones de las partes se geocodifican a diario con
OpenStreetMap Nominatim (solo la dirección, sin nombres); tras el inicio y cada seis horas se descarga un archivo de noticias de
www.ironstick.legal; no se envía ningún dato de expedientes ni personal al fabricante del software
(secciones 1 y 7).
- IRONSTICK SERVER. Opcional, en el NAS propio del despacho dentro de su red local, sin conexiones
a internet. Los documentos llegan al servidor y residen en él solo como archivos cifrados con AES-256;
el servidor nunca ve su texto en claro. El tiempo de trabajo por expediente
y los eventos de copia de seguridad de cada puesto de trabajo son visibles para el administrador del despacho
(sección 9).
1. Ámbito y endpoints
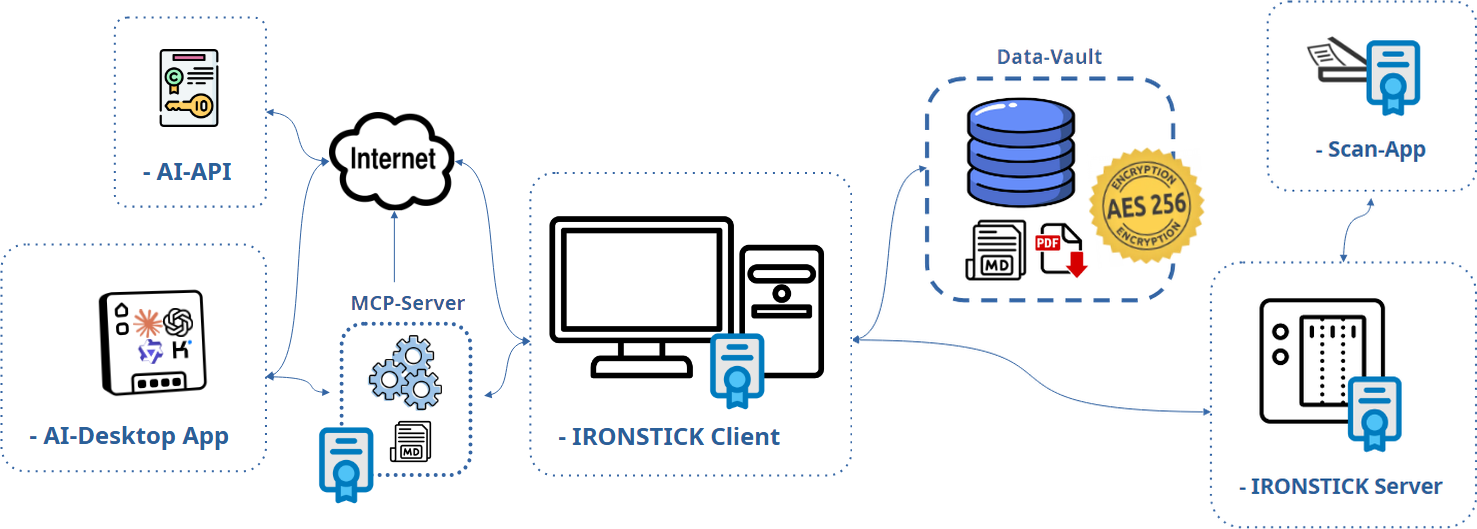
Las llamadas externas de IA dentro de la aplicación se dirigen al proveedor que la cascada automática
esté utilizando en ese momento. El usuario puede configurar hasta cuatro proveedores; se utilizan
los proveedores para los que se ha introducido una clave, en este orden fijo, empezando por el de menor coste:
Qwen (Alibaba Cloud) → Kimi (Moonshot AI) →
ChatGPT (OpenAI) → Claude (Anthropic). En cada inicio del programa, IRONSTICK
comprueba cuáles de ellos responden. Si un proveedor falla, la misma solicitud pasa al
siguiente. El proveedor que ha fallado se vuelve a intentar tras un tiempo de espera que depende del
error; solo se
omite durante el resto del día cuando su crédito se ha agotado o se desconoce la causa. El contenido transmitido
es idéntico con todos los proveedores (a partir de la sección 3: seudonimizado por el
router, consentimiento, registro de auditoría). Los endpoints son:
- Claude:
POST https://api.anthropic.com/v1/messages,
con la propia clave API del usuario.
- ChatGPT:
POST https://api.openai.com/v1/chat/completions,
con la propia clave API del usuario.
- Qwen:
POST https://dashscope-intl.aliyuncs.com/compatible-mode/v1/chat/completions
(Alibaba Cloud Model Studio, región internacional), con la propia clave API del usuario.
- Kimi:
POST https://api.moonshot.ai/v1/chat/completions
(Moonshot AI), con la propia clave API del usuario.
Proveedores gratuitos para tareas en segundo plano (opcional). Además, el usuario puede
configurar las ofertas gratuitas de Groq, OpenRouter y Mistral.
IRONSTICK las utiliza exclusivamente para tareas que se ejecutan en segundo plano:
clasificación de correo electrónico, Monitor de coherencia de datos, informe diario, resumen del diálogo,
asignación de interlocutores en las transcripciones, obtención de textos legales y panorama de
situación. Cada uno de estos proveedores tiene en la configuración su propio interruptor
de activación/desactivación; solo se utiliza si hay una clave guardada y su interruptor está
activado. Para el chat, para los escritos y para la revisión Red/Blue Team nunca se
utilizan. Si ninguno de ellos está disponible, se encarga la cascada descrita más arriba.
La seudonimización, el consentimiento y el registro de auditoría se rigen por la tarea
correspondiente (sección 4). Los endpoints son:
- Groq:
POST https://api.groq.com/openai/v1/chat/completions,
con la propia clave API del usuario.
- OpenRouter:
POST https://openrouter.ai/api/v1/chat/completions,
con la propia clave API del usuario.
- Mistral:
POST https://api.mistral.ai/v1/chat/completions,
con la propia clave API del usuario.
Ofertas gratuitas — aviso en la configuración. En la configuración, un aviso bajo cada uno de estos proveedores indica que IRONSTICK lo utiliza — siempre que la clave API esté guardada y el interruptor activado — para tareas en segundo plano como resúmenes y clasificación de correos, transmitiendo con ello datos a este proveedor. Antes de activar cualquiera de
estos proveedores, compruebe si sus condiciones prevén el contrato de encargo del tratamiento
exigido para los encargados y cumplen sus normas profesionales. Un proveedor
desactivado no se utiliza.
Se utilizan tres niveles de modelo configurables por proveedor (pequeño / mediano /
grande). Un canal independiente y opcional es el
Bridge de IA de escritorio (sección 4.9): en él, los datos fluyen hacia la IA de escritorio
local propia del usuario (Claude Desktop / Claude Code, ChatGPT Desktop, Qwen
Desktop o Kimi Desktop), es decir, hacia el proveedor de esa IA (Anthropic, OpenAI,
Alibaba Cloud/Qwen o Moonshot AI/Kimi), en el marco de la propia suscripción/cuenta del usuario con dicho proveedor. Los
Bridges pueden funcionar en paralelo: cada IA de escritorio tiene su propio pequeño programa de Bridge,
todos ellos se conectan al mismo endpoint local de la aplicación en ejecución, y
pueden trabajar al mismo tiempo en el mismo expediente. No se envía ningún dato de expedientes ni personal
al fabricante del software. El único contacto con el fabricante es una descarga simple de un archivo de noticias
desde www.ironstick.legal (tras el inicio y cada seis horas, sección 7),
que no transporta datos aparte de la propia conexión técnica.
IRONSTICK SERVER (sección 9) no altera esta situación: es
operado por el propio despacho, en el hardware propio del despacho, dentro de la
red propia del despacho — nunca contacta con el fabricante ni con ningún proveedor
de IA.
El interruptor principal es el acceso propio del usuario. El tratamiento
externo de IA dentro de la aplicación solo existe si el usuario ha abierto su propia cuenta
con un proveedor de IA e introducido su propia clave de acceso en la configuración.
Sin ningún proveedor configurado no puede producirse en absoluto ninguna llamada externa de IA dentro de la aplicación — todas
las funciones descritas en la sección 4 permanecen entonces locales o simplemente no están disponibles. Dicha
cuenta constituye un contrato directo entre el usuario y el proveedor; IRONSTICK no
es parte del mismo. Lo mismo se aplica al Bridge de IA de escritorio, que requiere
la propia suscripción/cuenta del usuario con el proveedor de IA de escritorio elegido
(Anthropic, OpenAI, Alibaba Cloud/Qwen o Moonshot AI/Kimi). Los documentos marcados como secretos quedan excluidos
de las herramientas del Bridge y del chat, del paquete de instrucciones
de IA y de toda salida generada (anexos, dosieres, exportaciones);
su tratamiento durante el registro sigue la elección deliberada del usuario en el
momento del registro (sección 4.1).
Completamente local (nada sale del equipo): extracción de texto y OCR, la
capa de chat local determinista, la búsqueda global, el radar de relevancia, el análisis de
cadenas de cartas, la generación de dosieres/PDF, la pasada local del buscador de anonimización, el reconocimiento de voz (transcripción de grabaciones) y la elaboración del paquete de instrucciones de IA.
2. La capa de seudonimización
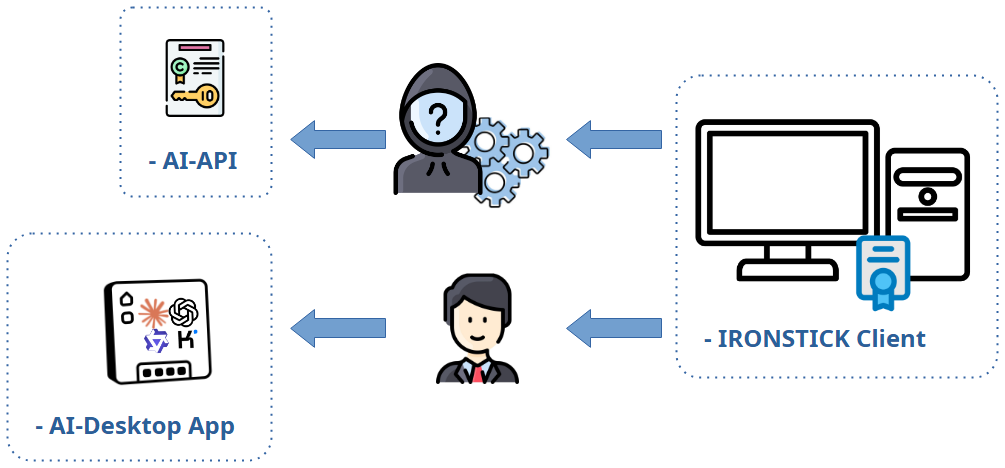
Toda llamada dentro de la aplicación a través del router central de IA se seudonimiza de forma predeterminada:
los identificadores del texto saliente se sustituyen por tokens y la respuesta se restituye localmente. Si el seudonimizador no puede construirse
por completo, no se envía nada. Las excepciones se enumeran en 2.3. La correspondencia existe
únicamente en memoria, con una correspondencia nueva por operación; nunca se almacena.
2.1 Qué se sustituye
| Origen | Campos | Familia de tokens (identificadores internos) |
|---|
| Registros de clientes | nombre, número de identificación nacional del campo de identificación (p. ej., el CNP rumano), teléfono, correo electrónico, dirección y localidad |
$PARTEI_A$ (parte), $CNP_A$ (n.º de identificación), $TEL_A$ (teléfono), $MAIL_A$ (correo electrónico), $ADRESSE_A$ (dirección) |
| Personas / entidades | nombre completo (persona o empresa), número de identificación nacional o de empresa del campo de identificación (p. ej., el CNP o el CUI rumanos) |
$PARTEI_B$ (parte) / $FIRMA_A$ (empresa), $CNP_B$ (n.º de identificación) |
| Expedientes | número de expediente, parte contraria, demandante |
$FALL_A$ (expediente), $PARTEI_C$ (parte)… |
| Capa de patrones (valores desconocidos en texto libre) |
números de expediente judicial, números de identificación personal, IBAN, direcciones de correo electrónico
y números de teléfono. Otros números de identificación nacionales solo se sustituyen si están almacenados en el registro del cliente o de la persona. | las mismas familias de tokens |
2.2 Qué permanece real de forma deliberada
- Fechas, horas e importes monetarios — se necesitan sin cambios para la evaluación jurídica.
- Nombres de instituciones (tribunales, autoridades) — no figuran en el
diccionario y son organismos públicos.
- Terceros sin registro propio — testigos, médicos, abogados, jueces o empresas que no están registrados como cliente, persona o expediente; quien deba sustituirse por un token se registra simplemente como persona.
- Direcciones de quienes no son clientes — se tokeniza la dirección almacenada del cliente.
- La totalidad del contenido fáctico de los documentos (alegaciones, diagnósticos,
relato) — solo se sustituyen los identificadores, no la historia.
2.3 Excepciones deliberadas con nombre real (en claro)
- Investigación web de personas (fase 1) y autocompletado de formularios para personas /
instituciones: una búsqueda web de
$PARTEI_A$ carece de sentido, por lo que el
nombre real se envía por diseño.
- Buscador de IA de anonimización: recibe texto que ya ha sido anonimizado
localmente y debe responder con los nombres reales de los terceros desconocidos que
encuentre — la seudonimización está desactivada para este único fin.
- Preprocesamiento de lectura en voz alta (TTS): véase 4.6 — las frases salen en texto
claro.
- Bridge de IA de escritorio: datos sin procesar por diseño (sección 4.9).
3. Momentos de consentimiento y registro de auditoría
Las llamadas encaminadas a través del router central están sujetas a consentimiento y se registran: cada
ronda del modelo escribe una fila en la tabla de auditoría local con
la solicitud y la respuesta completas en la forma tokenizada que realmente salió del
equipo; los intentos rechazados o bloqueados se registran sin contenido. Cuando una función
pide consentimiento, el cuadro de diálogo indica el nivel de modelo y el tamaño aproximado de la solicitud, y una aprobación cubre
la sesión de pantalla actual (en el registro de documentos: la ejecución actual del programa).
Flujos del router sin cuadro de diálogo de consentimiento propio:
la clasificación de correo electrónico (tanto en funcionamiento en segundo plano como en una recuperación manual
en la pantalla de correo, sección 4.2), la ejecución de análisis del Monitor de coherencia de datos (4.5),
el informe diario (4.4a), el resumen del diálogo del chat de API y la revisión Red/Blue
Team (4.7), y el buscador de IA de anonimización (activar su interruptor constituye el
consentimiento). Estos
siguen estando seudonimizados (salvo las respuestas con nombres reales previstas del buscador de anonimización)
y siguen siendo auditados.
Flujos que eluden el router: las funciones de IA del procesador de textos,
el preprocesamiento de lectura en voz alta y la llamada de corrección por IA de File→Markdown
llaman directamente a la API. Están seudonimizados (excepción: lectura en voz alta),
pero no muestran ningún cuadro de diálogo de consentimiento propio ni escriben filas
en el registro de auditoría. El manejo de estas funciones por parte del usuario (pulsar el botón de IA,
iniciar una generación, iniciar la lectura en voz alta con el interruptor de IA activado) constituye el
momento del consentimiento.
4. Los flujos de datos, caso de uso por caso de uso
4.1 Registro de documentos
La extracción de texto y el OCR son locales. Si hay una clave API configurada, IRONSTICK pregunta
una vez por ejecución del programa y, a continuación, se ejecutan hasta cuatro tipos de llamada (todos seudonimizados, todos
auditados):
- Detección del documento principal (nivel pequeño): extractos del texto OCR sin procesar — solo para escaneos de baja calidad.
- Corrección de OCR (nivel pequeño): un extracto limitado del texto del documento.
- Clasificación (nivel mediano): un extracto limitado del texto del documento, más listas del sistema: la lista completa de expedientes (número de expediente,
nombre del cliente, parte contraria — tokenizados), un repertorio de nombres conocidos (tokenizado) y las listas de códigos de tipo de institución y de tipo de documento
(etiquetas no tokenizadas). Alternativa: nivel pequeño, sin las
listas.
- Contextualización al guardar (nivel pequeño): los metadatos del documento y
el texto completo con longitud limitada, más una línea de índice (ID, fecha, título) de cada elemento de prueba activo del mismo cliente — utilizada para fundamentar
las referencias cruzadas. Se ejecuta también para documentos marcados como secretos (decisión deliberada
del usuario).
4.2 Monitor de correo (clasificación)
La asignación al expediente se realiza de forma local y sin IA. El correo nuevo se recupera
en segundo plano al iniciar y, después, cada cinco minutos. Un correo cuyo expediente
ya identifica el reconocimiento local (número de expediente, número de carta, número de cliente
o referencia a un escrito propio) no provoca ninguna llamada de IA. Para cada uno de los demás
correos, una llamada de nivel pequeño evalúa la urgencia con exactamente: nombre y
dirección del remitente, asunto y el fragmento de vista previa almacenado como texto sin formato (limitado estrictamente) — nunca el cuerpo completo, ningún adjunto y
ninguna lista de expedientes. Respuesta: prioridad y justificación. Si están activados
proveedores gratuitos para tareas en segundo plano (sección 1), esta llamada puede realizarse a
través de ellos. No se muestra ningún cuadro de diálogo de consentimiento, ni en funcionamiento en segundo plano ni
en una recuperación manual en la pantalla de correo: la clasificación se ejecuta automáticamente en cuanto se han configurado una cuenta de correo
y un proveedor de IA. Seudonimizada y auditada.
Sin píxeles de seguimiento. Abrir un correo en el monitor nunca contacta con
el servidor del remitente: las imágenes referenciadas mediante una dirección de internet (incluidos
los píxeles de seguimiento invisibles) no se cargan y aparecen como marcadores con un
aviso, de modo que el remitente no puede saber cuándo, con qué frecuencia ni desde qué dirección se
leyó un correo. Solo se muestran las imágenes incrustadas en el propio correo.
4.3 Análisis de personas (investigación web)
Tres fases, tras un consentimiento único por sesión:
- Fase 1 — búsqueda: los motores de búsqueda se consultan directamente desde el
ordenador del usuario; adicionalmente, se
invoca la herramienta de búsqueda web del lado del servidor del proveedor con el nombre real
de la persona en texto claro (inevitable para una búsqueda; registrado en texto claro).
- Fase 2 — resúmenes de páginas (nivel mediano): por página, el nombre de la persona
(tokenizado), la URL y un extracto limitado del contenido de la página.
- Fase 3 — síntesis del perfil (nivel grande): nombre y localidad (tokenizados)
más los textos de páginas recopilados, con longitud limitada por fuente.
El resultado se almacena localmente con la fiabilidad «no confirmado». Los botones de
autocompletado correspondientes en los formularios de persona/institución envían igualmente el
nombre introducido en texto claro (excepción documentada).
4.3a Comprobación de una parte en fuentes públicas
La comprobación de una parte en fuentes públicas es un procedimiento fijo que la propia aplicación
ejecuta cuando una IA conectada la invoca con nombre, localidad, distrito, país y
la clase de parte (persona física o persona jurídica):
- Expedientes: una búsqueda de texto completo del nombre en la base de datos
local — puramente local, nada sale del equipo.
- Internet: se envía una lista fija de consultas de búsqueda a los motores de búsqueda
públicos Google, DuckDuckGo y Qwant. Cada consulta consta de un
término de búsqueda en el idioma del país de la parte más el nombre real
de la parte en texto claro y, en algunas consultas, la localidad o el distrito
(inevitable para una búsqueda). No se transmite ningún contenido de expedientes, clientes ni
documentos. Los motores ven las consultas como las de cualquier usuario de un navegador.
El resultado se devuelve a la IA que realizó la llamada como perfil preparado y no verificado.
No se escribe nada en los datos maestros: cada hallazgo pasa por el control de revisión
del Monitor de coherencia de datos (sección 4.5) y solo se adopta cuando el
usuario lo acepta. Solo se evalúan fuentes de acceso público.
4.4 Diario diario
La pantalla en sí es local. La importación de texto libre ejecuta en primer lugar un analizador
local; solo cuando no se encuentra ningún marcador de formato de diario diario, una alternativa de IA
normaliza el texto sin procesar: el texto pegado se envía completo, nivel pequeño, sujeto a consentimiento, seudonimizado, auditado. Las entradas
almacenadas del diario diario solo salen del equipo como resultados de herramientas del chat o del Bridge
de IA de escritorio (extractos limitados) o dentro del paquete de instrucciones de IA (sección 5).
4.4a Informe diario
En el primer inicio del programa de cada día (Windows), IRONSTICK
prepara en segundo plano un informe diario hablado, ya durante el arranque y
antes de que la ventana del informe pregunte si el usuario desea escucharlo. El texto del
informe — recuento de plazos, vistas judiciales de hoy y de mañana con número de expediente,
nombre del cliente, localidad y tribunal, y los títulos de las citas de hoy — se envía
una vez (nivel pequeño) a la IA en la nube, que lo reformula como prosa hablada en el
idioma del sistema. Seudonimizado a través del router, auditado, sin cuadro de diálogo de
consentimiento. Si están activados proveedores gratuitos para tareas en segundo plano (sección 1), esta llamada
puede realizarse a través de ellos. Si no hay ningún proveedor disponible, se utiliza en su lugar un texto
compuesto localmente.
4.5 Monitor de coherencia de datos
La fase 1 (correo electrónico ↔ datos maestros) es completamente determinista. La fase 2 envía
por cada nuevo documento entrante una llamada de nivel pequeño (seudonimizada, auditada,
sin cuadro de diálogo) que contiene: los fragmentos de zonas de contacto desduplicados
(extractos breves en torno a datos de dirección, teléfono y datos fiscales) del texto completo de
ese documento, los nombres de las partes de ese documento y de su expediente, así como, para
cada parte, los nombres de las posibles coincidencias en los datos maestros almacenados
(tokenizados cuando figuran en el diccionario; nombres de instituciones en claro).
Los datos de contacto y los números de identificación de los datos maestros almacenados no se transmiten. Si
están activados proveedores gratuitos para tareas en segundo plano (sección 1), esta llamada
puede realizarse a través de ellos. La respuesta solo llega a ser una sugerencia que el
usuario debe aceptar en el monitor.
4.6 Procesador de textos (asistencia de IA en el texto)
- Revisar la selección: la frase/el párrafo/la sección seleccionados (con
marcado) más un extracto del documento como contexto
y la instrucción del usuario — nivel mediano, seudonimizado.
- Estructura/índice: en la práctica, todo el documento como lista de líneas indexada
(las líneas largas truncadas), con longitud limitada — nivel mediano, seudonimizado.
- Preprocesamiento de lectura en voz alta: al leer un documento en voz alta, cada
frase se envía individualmente al nivel pequeño en texto claro para desarrollar
abreviaturas y números — sin seudonimización (los números de identificación
deben volver sin cambios para leerse correctamente). Los sellos de archivo y los marcadores de
referencia se eliminan previamente de forma local. Iniciar la lectura en voz alta constituye el momento del
consentimiento.
Ninguna de las llamadas del procesador de textos muestra un cuadro de diálogo de consentimiento
propio ni escribe filas en el registro de auditoría (elusión del router, véase la sección 3).
4.7 Revisión Red/Blue Team y resumen del diálogo (API)
Otros dos flujos de API forman parte de la redacción. Red/Blue Team: si el usuario
lo ha activado para el proveedor activo (interruptor junto a la clave API; se requiere una clave
guardada), cada documento formal entregado a través del cuadro de diálogo de
entrega — tanto desde el chat de la aplicación como desde el Bridge
de IA de escritorio — es leído una vez más por el mismo proveedor en el papel de letrado de la parte contraria
en una pasada de revisión independiente (nivel mediano). Se transmite: el texto del borrador, la fecha y la
jurisdicción del expediente; seudonimizado a través del router y auditado como cualquier llamada
del router; sin cuadro de diálogo de consentimiento — el interruptor constituye el consentimiento; el informe del revisor se adjunta para el usuario. La revisión Red/Blue Team nunca se realiza
a través de los proveedores gratuitos para tareas en segundo plano (sección 1). Resumen del diálogo: en sesiones
largas del chat de API, la parte más antigua del diálogo (solo las preguntas del usuario y las
respuestas finales del modelo, nunca resultados de herramientas) es condensada por el proveedor activo
(nivel pequeño, en segundo plano, sin cuadro de diálogo de consentimiento propio) en un resumen breve que sustituye al historial
sin procesar; se almacena cifrado en el almacén temporal y se sobrescribe cada
vez. Seudonimizado y auditado. Si están activados proveedores gratuitos para tareas en segundo plano (sección 1), el
resumen puede realizarse a través de ellos.
4.8 Chat de IA (externo, API)
Consentimiento una vez por sesión de chat; nivel mediano con escalado automático al
nivel grande (en ese caso se vuelve a enviar todo el contexto); seudonimizado; cada ronda
auditada. Cada turno transmite: la instrucción del sistema (reglas estáticas), el contexto
actual de la interfaz (pantalla actual, expediente/cliente abierto, incl. el nombre del cliente — tokenizado),
hasta 10 entradas de memoria de IA del cliente abierto, el diálogo más reciente más un resumen de los turnos anteriores
(4.7) y la lista de archivos temporales del chat. Cada herramienta que invoca el modelo
devuelve su resultado a la conversación de la API — incluidos los textos completos de documentos
(los resultados mayores se depositan en el almacén temporal cifrado), los cuerpos de correo electrónico y
los extractos del diario diario. El chat utiliza la misma capa de
herramientas y los mismos controles de entrega que el Bridge de IA de escritorio (4.9): verificación
de escritos, Red/Blue Team (4.7) y entrega a través del cuadro de diálogo de exportación —
lo que sale del sistema es una plantilla lista para su presentación. La capa de chat local
responde a las solicitudes rutinarias sin transmisión alguna.
Dos funciones auxiliares merecen mención expresa. La consulta meteorológica
obtiene datos meteorológicos actuales de un lugar indicado del servicio no LLM
Open-Meteo (sección 7) — a dicho servicio solo se transmite el nombre del lugar / sus coordenadas,
nunca datos de expedientes ni de personas. La consulta de ubicación
responde exclusivamente a partir de la instantánea de seguridad más reciente almacenada
localmente (sección 8): la solicitud de la IA no desencadena ninguna nueva consulta externa —
solo lee lo que ya está en el disco. Como con cualquier herramienta, lo que estas funciones
devuelven fluye de vuelta a la conversación de IA, es decir, al proveedor de IA.
4.9 Bridge de IA de escritorio (módulos adicionales opcionales)
Cada acceso a una IA de escritorio es un módulo opcional que se adquiere por separado.
Solo existe cuando el despacho ha adquirido e instalado el correspondiente
módulo de Bridge; sin ningún módulo, la sección del Bridge permanece bloqueada en la
configuración, el endpoint local nunca se inicia y no puede producirse ninguno de los flujos
descritos en esta sección. Existen Bridges para
Claude Desktop/Claude Code, ChatGPT Desktop,
Qwen Desktop y Kimi Desktop; cada uno tiene su propio pequeño programa de
Bridge, y todos ellos se conectan al mismo endpoint local de la aplicación en
ejecución. Los flujos de datos que se describen a continuación son idénticos para todos; solo
difiere el proveedor receptor.
Este canal transmite datos reales de expedientes. Esa es su finalidad: la propia sesión de IA de escritorio del usuario redacta
plantillas listas para su presentación y, por ello, necesita nombres y números reales.
- La IA de escritorio (Claude Desktop/Code, ChatGPT Desktop, Qwen Desktop o Kimi Desktop) se conecta a través de su programa de Bridge con la aplicación en ejecución; esta conexión permanece en el ordenador. Solo las herramientas de búsqueda web, de lectura de páginas y de registros acceden a internet.
- Sitios web con verificación de acceso. Si un sitio web exige una confirmación antes de
mostrar su contenido, IRONSTICK abre la página en una ventana propia; el usuario
confirma allí él mismo. A continuación, el contenido de la página lo lee la IA de escritorio —
y llega a su proveedor como cualquier otro resultado de herramienta.
- El primer acceso a datos de cualquier IA de escritorio en una ejecución del programa abre un único cuadro de diálogo
de consentimiento bloqueante. La aprobación abre el acceso a todas las IA de escritorio durante el resto de la
ejecución del programa; el rechazo las bloquea a todas temporalmente.
- Más de 200 herramientas dan acceso a crónicas, textos completos, correos electrónicos,
diarios diarios, plazos, datos maestros, expedientes completos (por partes) y formatos
de salida; los documentos marcados como secretos quedan excluidos. Los cambios en los datos maestros,
la crónica, el calendario, la memoria de IA, los textos completos y la biblioteca jurídica solo surten efecto
después de que el usuario los apruebe, en un formulario de IRONSTICK,
un cuadro de diálogo o el Monitor de coherencia de datos: las sugerencias de datos maestros y de relaciones
llegan al monitor; los cambios propuestos por la IA a las notas de instrucciones de IA vinculadas a un expediente se
presentan como diff rojo/verde y solo se aplican después de que el usuario los acepte
expresamente; la IA nunca escribe entradas de crónica — solo rellena previamente el formulario de
registro, que el usuario completa y guarda; y un texto completo de documento
sanado por la IA (nuevo escaneo OCR) sustituye al texto completo almacenado solo después de que
el usuario haya visto el texto completo en un cuadro de diálogo de confirmación y lo haya guardado.
Sin un cuadro de diálogo de ese tipo, la IA solo escribe en sus propias áreas de trabajo: el almacén temporal
cifrado, el diario diario a petición del usuario y su propia evaluación del expediente tras las comprobaciones
deterministas. Las etiquetas y los mensajes del chat del despacho requieren la confirmación del usuario en el chat.
En un expediente suscrito de un compañero, la IA puede fijar una nota que viaja a través de
IRONSTICK SERVER hasta el titular del expediente y todos los suscriptores
(sección 9). La entrega al procesador de textos y la entrega de archivos son pasos
explícitos del usuario; la navegación, solo si se ha permitido por separado.
- Sanación mediante nuevo escaneo OCR (local) y entrega del PDF (iniciada por el usuario).
Cuando un texto completo almacenado está truncado o estropeado por una ejecución de OCR antigua, la IA puede
solicitar un nuevo escaneo: el usuario elige las páginas, el nuevo escaneo se ejecuta localmente
(sin nuevo destinatario externo) y ambas versiones del texto se depositan en el almacén temporal
local; lo que la IA lea de ellas fluye hacia su proveedor como cualquier
otro resultado de herramienta. Como último recurso absoluto — solo tras dicho nuevo escaneo y
solo dentro de límites estrictos impuestos por el Bridge —
la IA puede pedir al usuario que le entregue el archivo PDF original: IRONSTICK
solo abre la entrada; el usuario guarda el PDF mediante el icono del clip
y lo arrastra al chat de la IA de escritorio. Con ello, el documento se transfiere
como archivo (incluidos sellos, firmas e imágenes) al proveedor de esa
IA — esto sucede exclusivamente por acción propia y deliberada del usuario, nunca
de forma automática, y los documentos marcados como secretos quedan excluidos desde el principio de todo el
canal de nuevo escaneo.
- Almacén temporal local de la IA (minimización de datos). Los resultados extensos de las herramientas pueden depositarse en un archivo temporal local y cifrado y reelaborarse allí sin transmitirse en absoluto al proveedor
de IA. Las exportaciones completas de expedientes para la IA y la visión general de inicio de sesión
en una sola llamada se escriben igualmente directamente en este almacén local; solo
las partes que la IA lee posteriormente fluyen hacia su proveedor.
El almacén temporal se encuentra dentro de la carpeta
de datos y persiste entre sesiones (es el contexto de trabajo de la IA);
los archivos que ya no se utilizan se eliminan automáticamente, y no se crea ningún nuevo destinatario externo.
- El almacén temporal está cifrado.
Cada archivo del almacén temporal está cifrado en reposo con AES-256; los archivos solo salen del
almacén a través del cuadro de diálogo de exportación de IRONSTICK, nunca hacia una carpeta de descargas.
La base de datos, el almacén de documentos, el archivo de configuración y el almacén
temporal están, por tanto, cifrados en reposo con AES-256. Las copias de trabajo temporales de los documentos
abiertos (se borran en cada inicio y al cerrar), el búfer de revisión por pares de corta duración,
la bandeja de entrada de escaneos, las exportaciones y los archivos salientes permanecen en texto claro
(sección 8).
- Los resultados de las herramientas se entregan al cliente de IA de escritorio del usuario y, desde allí,
a su proveedor: Anthropic para Claude (en el marco de la suscripción de Claude del usuario
y de las condiciones de Anthropic), OpenAI para ChatGPT (en el marco de la suscripción de
ChatGPT del usuario y de las condiciones de OpenAI), Alibaba Cloud/Qwen para Qwen
Desktop (en el marco de la cuenta de Qwen del usuario y de las condiciones de Qwen) o Moonshot AI para Kimi
Desktop (en el marco de la cuenta de Kimi del usuario y de las condiciones de Moonshot AI). IRONSTICK no escribe
filas en el registro de auditoría para el tráfico del Bridge; la barra superior muestra un logotipo pulsante por cada
IA activa (marca de Claude, marca de ChatGPT, marca de Qwen, marca de Kimi) — el acceso simultáneo es
posible y cada uno se señaliza por separado. Cada programa de Bridge lleva un
registro local junto a sí mismo con la hora, el nombre de la herramienta, el éxito/fallo y el
tamaño de la respuesta, y nunca contenido. Un segundo registro de diagnóstico
más detallado en la carpeta de datos está desactivado de forma predeterminada; cuando se
activa para resolver problemas, puede contener en texto claro los parámetros de las llamadas (que pueden incluir nombres) y se recorta automáticamente. Ninguno de los dos registros se transmite a ninguna parte.
- La memoria de IA compartida almacena localmente conocimientos destilados (vinculados a un cliente o a un expediente). La IA puede proponer guardar, modificar o eliminar una
entrada; cada cambio surte efecto solo después de que el usuario lo apruebe. Las entradas vinculadas a un
expediente nunca se eliminan automáticamente; las entradas sin expediente se eliminan
tras un año sin uso. El contenido de la memoria es visible para todos los canales
de IA y se transmite siempre que esos canales lo leen.
- La revisión por pares entre las IA de escritorio se realiza a través de IRONSTICK, no directamente
entre los proveedores: una IA deja un producto de trabajo (p. ej., un borrador) en un
búfer de intercambio local y de corta duración (archivos de texto plano en el equipo del usuario,
eliminados cuando se cierra la tarea y borrados por completo en cada reinicio de la aplicación) y una
nota de tarea; la otra IA lo lee cuando el usuario se lo indica. Esto no crea
ningún nuevo destinatario externo — lo que lee la IA revisora se transmite
a su propio proveedor exactamente igual que cualquier otro resultado de herramienta descrito anteriormente, en el marco de las condiciones de ese
proveedor. Los proveedores nunca intercambian datos directamente; lo que lee la IA revisora solo llega a su propio proveedor.
4.10 Transcripción de audio (asignación de interlocutores)
El reconocimiento de voz se ejecuta completamente en local; la grabación en sí nunca
sale del ordenador. Si el usuario ha indicado más de un interlocutor, la IA asigna
después las líneas reconocidas a los interlocutores: por partes (nivel medio) el texto reconocido, más las líneas ya asignadas como
contexto y el número de interlocutores. Las llamadas pasan por el router — seudonimizadas,
sujetas a consentimiento y registradas en el registro de auditoría. La respuesta no puede
alterar el texto: cada línea se comprueba contra el texto reconocido; si falla un bloque,
la transcripción se adopta sin asignación de interlocutores. Con un solo interlocutor no
se produce ninguna llamada a la IA. Si están activados proveedores gratuitos para tareas en
segundo plano (sección 1), estas llamadas pueden realizarse a través de ellos.
5. El paquete de instrucciones de IA (ZIP de exportación)
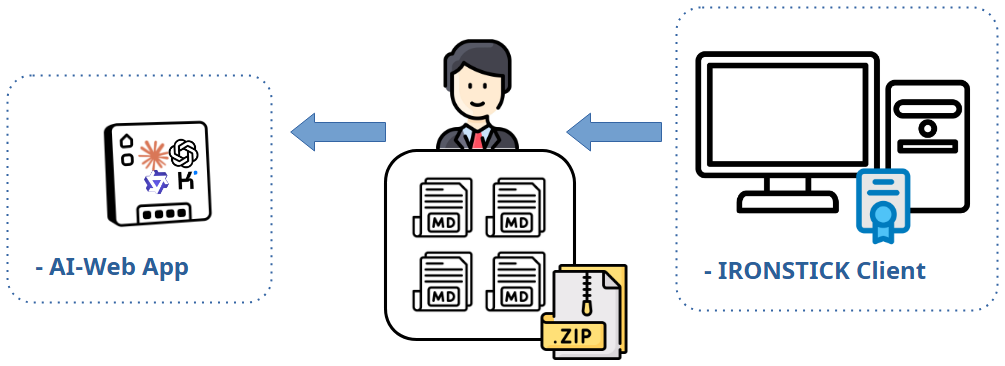
La elaboración del paquete es local y no implica ninguna llamada de IA. Produce
Markdown en texto claro (sin seudonimización) destinado a que el
usuario lo cargue en un LLM externo de su elección. Contenido:
| Archivo | Contenido |
|---|
| Expedientes | todos los expedientes del cliente seleccionado con partes, estado e
índice de ID de pruebas (sin textos completos) |
| Entidades | todas las personas/entidades de todo el despacho (no
solo de este cliente), incl. números de identificación personal y de empresa nacionales (p. ej., CNP/CUI rumanos), fecha de nacimiento, datos de contacto completos, profesión,
vehículo — más los bloques de análisis almacenados (valoración, vulnerabilidades,
domicilios, finanzas, entorno social, fuentes) |
| Instituciones, plazos | todas las instituciones; plazos activos con
números de expediente y nombre del cliente |
| Correo | los 100 correos electrónicos más recientes de todo el despacho: remitente,
destinatario, asunto, nombres de archivos adjuntos, fragmento breve (sin cuerpos completos) |
| Diario diario | últimos 10 días, de todo el despacho, incl. la cronología de
expedientes de ese periodo |
| Por expediente | un dosier por expediente: la crónica completa con los
textos completos de los documentos, identificadores
del cliente y de las partes, incl. números de identificación; más todas las notas de antecedentes del expediente sin límite |
| Archivos de instrucciones | cinco documentos de reglas de trabajo — sin datos personales |
Qué ocurre cuando este ZIP se carga en un servicio de IA de terceros:
el usuario transfiere personalmente, en texto claro, partes sustanciales de todo el
despacho — identidades de clientes con números de identificación nacionales, perfiles de terceros
incluidas valoraciones sensibles, metadatos de la correspondencia de todo el despacho y expedientes
— a ese proveedor. A partir de ese momento, los datos se tratan conforme a las condiciones
de ese proveedor (uso para entrenamiento, conservación, jurisdicción). IRONSTICK muestra una advertencia de privacidad antes de la
exportación (una vez por ejecución del programa) y ofrece la exportación también a Google Drive, lo que
deposita además los archivos en Google. El usuario actúa como responsable
transmisor en el sentido del RGPD y debe garantizar una base jurídica (p. ej., art. 6, normas de secreto
profesional) antes de la carga.
Los documentos marcados como secretos quedan excluidos de los plazos, los diarios diarios y los dosieres
de expedientes.
6. Matriz resumen
| Flujo | Qué sale (forma) | Seudonimizado | Cuadro de diálogo de consentimiento propio | Registro de auditoría |
|---|
| Registro de documentos (4 llamadas) | texto OCR y del documento (limitado), listas de expedientes y de nombres | sí | sí — una vez por ejecución del programa | sí |
| Clasificación de correo electrónico (recuperación manual en la pantalla de correo) | remitente, asunto, fragmento breve (sin lista de expedientes); solo para correos no asignados localmente | sí | no | sí |
| Clasificación de correo electrónico (segundo plano, cada cinco minutos) | ídem | sí | no | sí |
| Informe diario (API) | texto del informe: recuento de plazos, vistas judiciales con número de expediente, nombre del cliente, localidad y tribunal, títulos de citas | sí | no (primer inicio del día, preparado durante el arranque) | sí |
| Investigación de personas, fase 1 | nombre real (búsqueda web) | no — por diseño | sí — una vez por sesión | sí (en texto claro) |
| Investigación de personas, fases 2 y 3 | textos de páginas (limitados por fuente) | sí | mismo consentimiento | sí |
| Autocompletado de persona/institución | nombre introducido (búsqueda web) | no — por diseño | sí — una vez por sesión | sí (en texto claro) |
| Importación por IA del diario diario | texto sin procesar pegado | sí | sí | sí |
| Monitor de coherencia de datos | por cada nuevo documento: sus zonas de contacto y nombres de posibles coincidencias (sin datos de contacto ni números de identificación de los datos maestros) | sí (nombres de instituciones en texto claro) | no (segundo plano limitado) | sí |
| Procesador de textos: revisar / estructura | selección con extracto de contexto / líneas del documento (limitadas) | sí | no (botón = consentimiento) | no |
| Preprocesamiento de lectura en voz alta | cada frase, texto claro | no | no (inicio = consentimiento) | no |
| Revisión Red/Blue Team (API) | texto del borrador, fecha y jurisdicción | sí | no (interruptor = consentimiento) | sí |
| Resumen del diálogo (API) | turnos de diálogo anteriores (solo preguntas del usuario y respuestas finales) | sí | no (pasada en segundo plano del chat de API) | sí |
| Corrección por IA de File→Markdown | texto convertido | sí | no | no |
| Buscador de IA de anonimización | texto ya anonimizado; las respuestas contienen nombres reales de terceros | desactivado — por diseño | interruptor = consentimiento | sí |
| Chat de IA (externo) | instrucción, contexto de la pantalla, memoria, diálogo reciente con resumen, resultados de herramientas (limitados por elemento) | sí | sí — una vez por sesión | sí |
| Bridge de IA de escritorio (Claude Desktop/Code, ChatGPT Desktop, Qwen Desktop, Kimi Desktop) | resultados de herramientas sin procesar (datos completos del expediente) | no — por diseño | sí — una vez por ejecución del programa para todas las IA de escritorio | no (lado de la aplicación) |
| Transcripción de audio: asignación de interlocutores | texto reconocido por partes — nunca la grabación | sí | sí | sí |
| Proveedores gratuitos para tareas en segundo plano (Groq, OpenRouter, Mistral) — solo si están activados | los mismos contenidos que la tarea en segundo plano correspondiente; nunca chat, escritos ni Red/Blue Team | según la tarea correspondiente | no (interruptor por proveedor = consentimiento) | sí |
| ZIP de instrucciones de IA | exportación del despacho en texto claro (carga iniciada por el usuario) | no | advertencia una vez por ejecución del programa | n/a |
7. Servicios externos no LLM (para mayor exhaustividad)
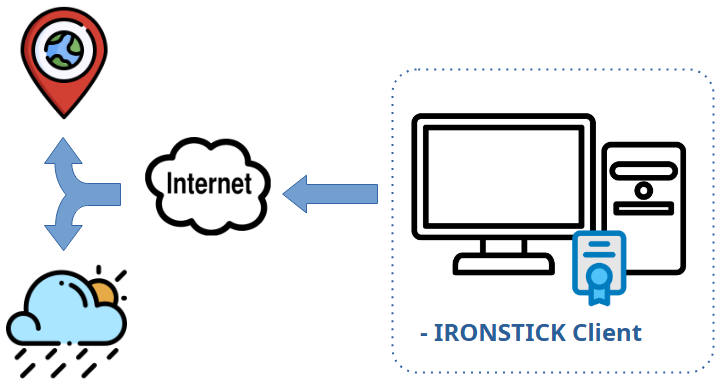
Con independencia de cualquier LLM, las siguientes funciones contactan con servicios externos con
los datos mínimos necesarios: validación de números (EU VIES, EORI, GLEIF, registros
mercantiles — el número que se comprueba), las consultas web directas de la búsqueda de personas (el nombre),
IMAP (su servidor de correo) y las exportaciones opcionales a Google Drive (los archivos exportados). Ninguno de ellos implica al
proveedor de IA.
Se contacta con los siguientes servicios en segundo plano o con datos igualmente
mínimos:
- OpenStreetMap Nominatim (geocodificación de direcciones) — una vez al día, un
trabajo en segundo plano recorre las personas y empresas de los registros de partes
que tienen dirección o localidad, y envía calle, distrito, localidad y país
(nunca el nombre) a Nominatim para situarlas en el mapa; una dirección ya
situada solo se vuelve a enviar cuando cambia, y una que no se encontró se reintenta
tras un periodo de espera. El nombre del lugar de la consulta meteorológica se geocodifica del
mismo modo. Sin cuadro de diálogo de consentimiento; las coordenadas se almacenan localmente.
- ipwho.is (consulta de geo-IP) — una vez por inicio del programa, como parte de la
instantánea de seguridad local (sección 8), IRONSTICK solicita a este servicio la
dirección IP pública del equipo y una ubicación aproximada (ciudad, país, ISP).
La solicitud no contiene ningún dato; el servicio recibe la dirección IP pública desde la
que llega la solicitud. La respuesta se almacena exclusivamente de forma local y no se transmite
a ninguna otra parte.
- Open-Meteo (meteorología) — a petición, la consulta meteorológica de IA (sección
4.8) obtiene datos meteorológicos actuales de un lugar indicado; el informe diario hace lo
mismo para la localidad almacenada en la configuración cuando está activado su modo opcional con
referencia meteorológica. Solo se transmiten las coordenadas del lugar — nunca
datos de expedientes, clientes ni personas.
- www.ironstick.legal (archivo de noticias) — una vez introducido el código de acceso
y, después, cada seis horas, la aplicación descarga del sitio web del fabricante del software un archivo de noticias con
avisos y advertencias, además de cualquier imagen a la que haga referencia. La solicitud no contiene datos; como cualquier servidor web, el servidor
del fabricante ve la dirección IP y la hora de la solicitud.
Ninguno de estos servicios implica al proveedor de IA.
8. Almacenamiento local, integridad y control del usuario
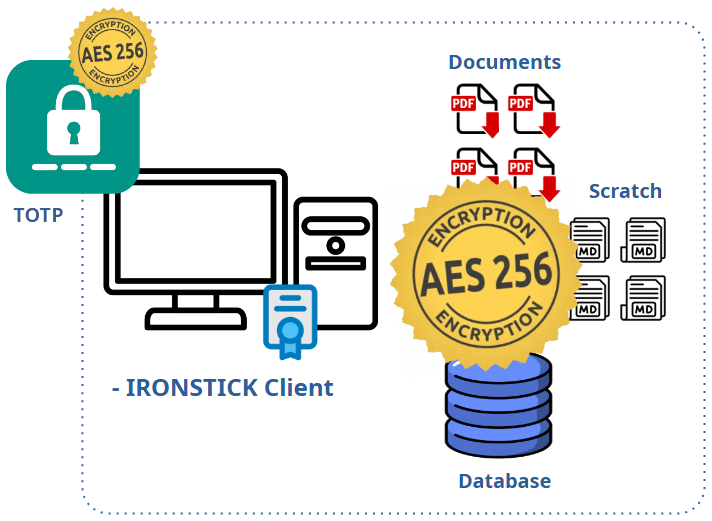
Con independencia de los canales de IA mencionados, lo siguiente se aplica a todos los
datos que conserva IRONSTICK:
- Almacenamiento exclusivamente local. La totalidad del conjunto de datos — base de datos, archivos
de documentos, medios, transcripciones, configuración — reside en un único directorio de datos en
una ruta que define el usuario. IRONSTICK no requiere ninguna cuenta en la nube,
y ninguna función envía datos del usuario al fabricante (el único contacto con el fabricante es la
descarga de noticias, sección 7). Cuando un despacho utiliza
el IRONSTICK SERVER opcional (sección 9), también ese servidor es un dispositivo propio del despacho
en la red propia del despacho — nada cambia en cuanto al acceso del fabricante.
- Base de datos cifrada en reposo (AES-256). La base de datos — el registro
de clientes, expedientes, crónica, correos electrónicos, plazos, texto de las transcripciones y la
memoria de las IA — se almacena cifrada con AES-256, cada página por separado y
con un sello de integridad por página. La clave la deriva la aplicación en
tiempo de ejecución y nunca se escribe en el disco ni en la configuración, de modo que un archivo de base de datos
copiado del soporte de almacenamiento o de un archivo de copia de seguridad no puede leerse sin
IRONSTICK. Se trata de una medida técnica en el sentido del art. 32 RGPD que
se aplica sin configuración alguna por parte del usuario y no puede desactivarse.
- Documentos cifrados en reposo (AES-256). El almacén de documentos — los
PDF originales, escaneos, imágenes, archivos de audio y de transcripción — se cifra del
mismo modo, archivo por archivo, con un sello de integridad que detecta cualquier alteración.
La lectura se realiza a través de un único control de acceso que descifra el archivo solicitado
en una copia de trabajo temporal y elimina dichas copias cuando la
aplicación se cierra o se inicia. Las copias de seguridad y los paquetes de expedientes contienen los documentos
en su forma cifrada.
- Qué permanece en texto claro. Además de las copias de trabajo de la sesión actual y de las exportaciones: los escaneos que esperan en la bandeja de entrada de escaneos antes de registrarse;
el búfer de revisión por pares de corta duración entre IA de escritorio (sección 4.9, se elimina
al cerrar la tarea y se borra en cada inicio); y, solo si se ha activado,
el registro de diagnóstico detallado del Bridge (sección 4.9).
- Control de acceso al inicio (TOTP). Una vez aceptada la clave de
licencia, la aplicación no muestra más que una solicitud de código hasta que el usuario
introduce el código de un solo uso basado en tiempo de seis dígitos vigente de una
aplicación de autenticación (RFC 6238). El secreto en que se basan los códigos
nunca se escribe en el disco; solo se almacena una
huella no secreta de la configuración confirmada, para que el código QR vuelva a
mostrarse tras un cambio de clave. Los códigos erróneos repetidos provocan una espera
creciente. Los Bridges de IA de escritorio no reciben ningún dato de expedientes mientras la aplicación
está bloqueada. El archivo de configuración (claves API, credenciales de correo electrónico,
acceso al servidor) se conserva cifrado con AES-256 mediante el mismo mecanismo que los
documentos y solo se descifra en memoria.
- Ubicación de almacenamiento controlada por el usuario. La ruta de datos se elige durante
la instalación y puede modificarse en cualquier momento — incluso a un soporte extraíble como
una unidad USB cifrada o un disco externo cifrado. La aplicación simplemente
sigue la ubicación configurada; el cifrado del soporte (p. ej., con el
cifrado de disco del sistema operativo) está en manos del usuario y se
recomienda para soportes portátiles. Las unidades de red y las carpetas sincronizadas con la nube
(OneDrive, Google Drive, Dropbox, iCloud, Box, pCloud, MEGA) se rechazan como ubicación de
datos. Al cambiar la ubicación de almacenamiento en la configuración, IRONSTICK comprueba el destino conforme a estas reglas; la copia se realiza con comparación de sumas de verificación, el cambio solo se produce tras una verificación satisfactoria y la carpeta antigua se conserva con otro nombre.
- Sincronización de dispositivos sin ninguna nube. La sincronización
opcional Windows ↔ tableta Android se realiza a través de una conexión directa por cable
USB — no interviene ningún servicio de terceros, las transferencias se
verifican mediante suma de comprobación y se realiza una copia de seguridad obligatoria antes de sustituir la base de datos.
Los documentos marcados como secretos nunca se transfieren a la tableta en
absoluto.
- Instantánea de seguridad al inicio (registro local de inicios de sesión). En cada inicio
del programa, IRONSTICK registra en segundo plano una instantánea del equipo en el que
se ejecuta: nombre de host, sistema operativo, RAM/CPU, dirección IP local, navegador
predeterminado, herramientas de acceso remoto en ejecución que detecta y una puntuación de
seguridad derivada — más, una vez por inicio, la dirección IP pública y la ubicación aproximada
(ciudad, país, ISP) obtenidas del servicio de geo-IP ipwho.is (sección 7).
La instantánea se almacena exclusivamente de forma local en la base de datos y no se transmite a ninguna parte. La conservación se limita
automáticamente a un máximo de 6 meses y a un máximo de 1.000
entradas (mantenimiento diario), y el usuario puede consultar el registro en cualquier
momento en el configurador (tarjeta «Registro de inicios de sesión»).
- Huellas de integridad en cada archivo registrado. En el momento del
registro, cada archivo almacenado recibe una huella criptográfica de su contenido
(SHA-256 para documentos y medios; una huella MD5 heredada para los archivos de audio
de transcripción), anotada en la base de datos junto a la entrada. Por tanto, cualquier modificación posterior de un
archivo almacenado es detectable comparando el archivo con su
huella registrada, y las exportaciones de e-discovery (EDRM) incluyen estas huellas
para que los destinatarios puedan verificar los archivos de forma independiente. Esto hace que cualquier manipulación sea evidente y demostrable.
- Copias de seguridad a discreción del usuario. Una función de copia de seguridad integrada escribe
una copia completa de los datos (copia de seguridad completa o solo de datos) como un único archivo
ZIP en cualquier destino que el usuario seleccione, y restaura a partir de dicho archivo
cuando se solicita. La frecuencia con que se realizan las copias de seguridad, dónde se guardan, cuánto tiempo se
conservan y si los archivos se cifran adicionalmente es decisión exclusiva del
usuario. Dentro de cada archivo, la base de datos, los documentos, la
configuración y el almacén temporal de IA están cifrados con AES-256 en todo caso; solo
los escaneos que aún esperan en la bandeja de entrada de escaneos se incluyen tal cual —
IRONSTICK no impone ningún calendario y no transmite las copias de seguridad a ninguna parte.
- Los documentos generados pertenecen al usuario. El usuario puede generar
documentos en cualquier momento — escritos, cartas, dosieres, listas, exportaciones — y
descargarlos: se escriben en la carpeta local Documentos o, cuando el
usuario selecciona expresamente Google Drive como destino, en la propia cuenta de Google Drive del usuario.
Lo que ocurra con un
documento generado a continuación — impresión, presentación ante un tribunal, envío por correo electrónico,
carga en cualquier servicio, comunicación a terceros — lo decide exclusivamente el usuario.
Atribución de responsabilidades. Dado que IRONSTICK almacena
todo localmente y transmite datos únicamente por las vías documentadas en las secciones
1–7 y 9 — incluidas las funciones en segundo plano que se ejecutan sin cuadro de diálogo
propio (secciones 3 y 7) —, el operador del despacho es el único responsable
del tratamiento: elige el soporte de almacenamiento y su cifrado, gestiona y
conserva las copias de seguridad, decide qué funciones de IA están activadas, otorga o deniega cada
consentimiento y decide por sí solo qué se hace con cada documento, exportación o copia de seguridad
que produce el software. El contenido generado por IA — borradores, resúmenes, valoraciones,
clasificaciones — es siempre una propuesta sobre la que decide el usuario. El presente documento existe para que cada
una de esas decisiones pueda adoptarse con pleno conocimiento de los flujos de datos
reales.
9. IRONSTICK SERVER (opcional, en la red propia del despacho)
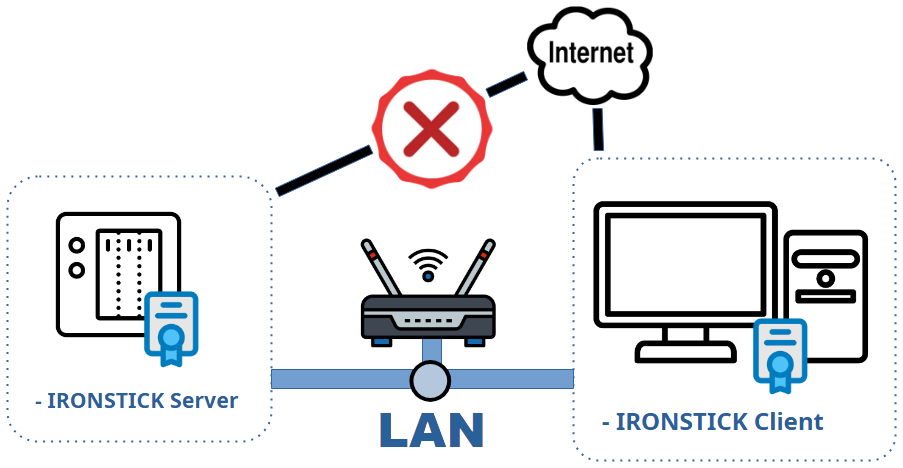
Los despachos con varios puestos de trabajo IRONSTICK pueden operar el
IRONSTICK SERVER opcional — un servicio de coordinación que se ejecuta en el propio
NAS Synology del despacho, dentro de la red local propia del despacho. A efectos de la presente
declaración, los hechos determinantes son:
- No interviene ninguna parte externa. El servidor es un dispositivo propio
del despacho. Solo acepta conexiones desde direcciones de red privadas (locales)
y nunca inicia ninguna conexión con internet — sin telemetría, sin
comprobaciones de actualizaciones, sin contacto con el fabricante. El fabricante del software no tiene acceso de ningún
tipo.
- Transporte y almacenamiento. Los documentos llegan al servidor y residen en él solo como archivos cifrados con AES-256, en el
mismo formato de caja fuerte que en el puesto de trabajo; el servidor nunca ve su texto en claro.
El servidor funciona en el NAS propio del despacho dentro de la red del despacho, sin conexiones a internet.
- Sin intervención de IA. El servidor no transporta tráfico de IA, no almacena ninguna clave
de IA y nunca se comunica con ningún proveedor de modelos de lenguaje. Todos los canales de IA
descritos en las secciones 1–6 permanecen estrictamente vinculados a cada puesto de trabajo; la
capa de seudonimización, los controles de consentimiento y el registro de auditoría no se ven afectados
por la presencia del servidor.
- Qué almacena el servidor — todo ello en el NAS, bajo el control
del despacho: (a) paquetes de expedientes compartidos — solo los expedientes que un usuario ha
liberado expresamente para sus compañeros; los documentos marcados como secretos quedan excluidos por diseño y
nunca llegan al servidor; (b) la biblioteca jurídica central — textos legales
públicos en Markdown, cada uno con el nombre del usuario que lo aportó, el enlace a la fuente
y la fecha de revisión; (c) registros de control horario — por usuario, día y
expediente: número de expediente, nombre del cliente y minutos, comunicados por cada puesto de trabajo en
segundo plano; (d) totales de presencia por usuario y día, derivados de
las señales de actividad de la sesión; (e) metadatos de eventos de expedientes — comparticiones, revocaciones,
inicios/finalizaciones de suscripciones y exportaciones, cada uno con fecha, hora y dirección
IP de la LAN; (f) un registro de seguridad con eventos administrativos y de inicio de sesión,
incluidas las direcciones IP de la LAN; (g) paquetes de traspaso de expedientes — cuando un usuario
transfiere la titularidad de un expediente a un compañero, el expediente completo viaja como un único
archivo a través de una zona de transferencia temporal del servidor; el paquete se elimina del
servidor después de que el destinatario haya confirmado la importación, y los documentos
marcados como secretos solo viajan tras una confirmación adicional expresa del titular
(en caso contrario, se interrumpe la transferencia); (h) la recepción central de
escaneos (Central Scan App opcional): un registro de los
números de expediente y del nombre visible de cada usuario (comunicados por los puestos de trabajo como
material de correspondencia — nunca contenidos de expedientes) y una cola de documentos
por archivo que conserva el correo entrante escaneado dirigido a un usuario hasta que el
puesto de trabajo de ese usuario lo ha recuperado y confirmado, tras lo cual se elimina la copia del
servidor; el reconocimiento de texto y la asignación del destinatario se realizan localmente en
el puesto de escaneo, sin ninguna IA; (i) registros de eventos de copia de seguridad —
cada puesto de trabajo comunica sus eventos de copia de seguridad y restauración de datos (tipo, nombre de
archivo, tamaño, hora, IP de la LAN), de modo que el administrador puede ver por usuario cuándo se realizó la
última copia de seguridad y recordárselo a los usuarios que se retrasen; (j) el directorio de partes
de todo el despacho — los registros maestros de
personas y empresas, instituciones, las relaciones entre ellas y los
análisis de personas que llevan los puestos de trabajo, junto con la cola de
propuestas de cambio intercambiadas entre usuarios; (k) las valoraciones de resoluciones judiciales — por puesto de trabajo y resolución: tribunal, órgano juzgador y composición, los nombres de los jueces y letrados, número de resolución, fecha, número de procedimiento, los números internos de caso y de cliente del puesto que valora, las proporciones de texto medidas y el análisis en inglés de la resolución y de los escritos de ambas partes redactado por la IA; (l) el chat del despacho — mensajes entre los usuarios registrados (se eliminan al cabo de un año) — y las notas fijadas en un expediente compartido, visibles para su titular y para todos los suscriptores.
- El directorio de partes de todo el despacho. En cuanto un puesto de trabajo se
conecta al servidor, sus datos maestros de partes (quién es quién: nombres,
identificadores, datos de contacto, relaciones, análisis de personas) se cargan
automáticamente y se replican en todos los demás puestos de trabajo del mismo despacho,
de modo que cada abogado ve con quién está tratando ya el despacho y el despacho
obtiene una visión de conflictos de intereses de todo el despacho. Cada registro tiene exactamente un
titular — el usuario que lo introdujo primero; todos los demás usuarios tienen una copia
de solo lectura y únicamente pueden enviar una propuesta de cambio, que el titular acepta o
rechaza en el Monitor de coherencia de datos. Si no es posible contactar con el titular durante 48 horas,
la titularidad pasa al usuario que formuló la propuesta. Los contenidos de los expedientes no forman parte de
este directorio — los documentos, la cronología, la correspondencia y las asignaciones de
expedientes siguen rigiéndose por las acciones expresas de compartición y traspaso
aquí descritas. El intercambio permanece dentro del despacho (un único responsable), nunca
sale de la red local y no implica a ningún proveedor de IA: la detección de duplicados
y la comparación de campos se ejecutan como lógica de programa ordinaria en el puesto de trabajo
emisor; el servidor solo almacena y reenvía. Los despachos deberían mencionar esta
compartición interna de datos de partes y de análisis de personas en su registro de
actividades de tratamiento.
- Las valoraciones de resoluciones judiciales. Una valoración solo se guarda por orden expresa del usuario; después, al igual que el directorio de partes, se sube automáticamente y se replica en cada puesto de trabajo del despacho. Cada puesto lleva su propia valoración por resolución, que solo él puede modificar. El análisis describe el contenido de una resolución y de los escritos correspondientes — en esa medida contiene contenido del caso — y nombra a jueces y letrados. No interviene ningún proveedor de IA; el intercambio permanece en la red local del despacho. Los despachos deberían recoger también esta comunicación en su registro de actividades de tratamiento.
- Solo acciones deliberadas — para el contenido de los expedientes. El contenido de los expedientes llega
al servidor exclusivamente mediante una acción expresa de compartición o de traspaso
confirmada por el usuario; los textos de la biblioteca jurídica solo después de que el usuario acepte la
entrada en el Monitor de coherencia de datos; el correo entrante escaneado solo después de que el empleado administrativo
haya revisado el documento y haya pulsado enviar a un destinatario elegido. El directorio de partes y las valoraciones guardadas de resoluciones judiciales son las excepciones deliberadas: se sincronizan en segundo plano sin confirmación por registro. Los registros de tiempo, presencia, eventos y
copias de seguridad son metadatos operativos generados por el propio funcionamiento multiusuario
y son visibles para el administrador del despacho en la administración web.
- Responsabilidad del tratamiento. El despacho que opera el servidor sigue siendo el único
responsable del tratamiento. El administrador controla la aprobación de registros, puede poner fin a
suscripciones, eliminar entradas de la biblioteca jurídica y desinstalar el paquete —
lo que deja el directorio de datos del servidor bajo el control del administrador en
el NAS.
- Datos de los empleados. Con IRONSTICK SERVER, cada
puesto de trabajo comunica al servidor su tiempo de trabajo medido por día y expediente (número de expediente,
nombre del cliente) y cada evento de copia de seguridad y de restauración (archivo, tamaño, hora, dirección IP),
y el administrador del despacho puede verlos. El despacho debe informar de ello a su
personal.
- Nombres completos de clientes en los registros de tiempo. La vista general del control horario
muestra el tiempo de trabajo por expediente y por cliente, lo que significa que los nombres de los clientes se
almacenan en el NAS. Esto permanece dentro de la infraestructura propia del despacho y de su
régimen de confidencialidad existente — pero los despachos deberían incluir el NAS en su
inventario de medidas técnicas y organizativas (control de acceso en el sistema operativo del NAS,
cifrado del volumen, política de copias de seguridad), exactamente igual que lo harían con cualquier servidor
de archivos de oficina.
Anexo — Cláusula modelo para su aviso de privacidad para clientes (propuesta)
El siguiente texto es una propuesta de redacción que un despacho que utilice IRONSTICK
puede copiar en su propio aviso de privacidad para clientes. Está redactado para ajustarse con exactitud a los
flujos de datos descritos anteriormente. Evita deliberadamente las citas de artículos legales para que
pueda insertarse en avisos de cualquier estructura.
Antes de insertarla — lista de comprobación para el abogado:
- Disponga del contrato de encargo del tratamiento de cada proveedor de IA que haya
configurado, mencione en la cláusula únicamente los proveedores que realmente utiliza y
contraste la frase sobre entrenamiento y conservación con las condiciones que realmente
ha firmado. Los proveedores gratuitos para tareas en segundo plano (Groq, OpenRouter, Mistral,
sección 1) solo los cubre la cláusula mediante la frase opcional entre corchetes que figura en
ella — actívelos solo si sus condiciones satisfacen los requisitos de sus normas profesionales,
y elimine la frase si no los utiliza.
- Mantenga la frase entre corchetes sobre el espacio de trabajo de IA solo si realmente utiliza
el Bridge de IA de escritorio (Claude Desktop/Code, ChatGPT Desktop, Qwen Desktop
o Kimi Desktop); en caso contrario, elimínela.
- Esta cláusula cubre los flujos dentro de la aplicación descritos en el presente documento. No
cubre el paquete de instrucciones de IA (sección 5) — cargar esa exportación
en cualquier servicio de IA es una decisión independiente y normalmente requerirá el consentimiento
expreso del cliente.
- Si ha desactivado funciones de IA concretas en el configurador, acorte
en consecuencia la lista de finalidades — describa exactamente lo que utiliza, nada más.
- Se trata de una propuesta de redacción, no de asesoramiento jurídico. Hágala revisar conforme a
las normas deontológicas de su colegio de abogados y a la práctica local en materia de protección de datos antes de utilizarla.
Español
Tramitación de expedientes asistida por IA. Nuestro despacho utiliza
el software de gestión IRONSTICK, que incluye funciones asistidas por
inteligencia artificial. Para estas funciones, determinados datos de su
expediente pueden transmitirse a un proveedor externo de servicios de IA
(según disponibilidad: Alibaba Cloud, Moonshot AI, OpenAI o Anthropic, a través de sus API), que los trata
por cuenta nuestra sobre la base de un contrato de encargo de tratamiento.
Utilizamos estas funciones para: la clasificación y el registro de documentos
entrantes, la priorización del correo electrónico entrante, la comprobación de
la coherencia de nuestros datos, la redacción y revisión de documentos
jurídicos, así como para el análisis y la investigación jurídica. [Opcional — eliminar si no se
utiliza: para las tareas que se ejecutan en segundo plano, como la priorización del correo
electrónico entrante, la comprobación de nuestros datos y los resúmenes, pueden utilizarse
además los servicios gratuitos de Groq, OpenRouter o Mistral; hemos revisado sus condiciones
antes de activarlos.]
Medidas de protección. Antes de cada transmisión, el software
sustituye en nuestro propio ordenador los identificadores directos almacenados
en el sistema — nombres, números de identificación personal, números de
teléfono, direcciones de correo electrónico, direcciones postales, números de
expediente y datos bancarios — por marcadores neutros. La tabla de
correspondencia entre marcadores y datos reales nunca sale del despacho; las
respuestas del proveedor se retraducen localmente. Solo se transmite lo
necesario para la función concreta, con límites de volumen fijos. Algunas
funciones requieren técnicamente datos reales — por ejemplo, la búsqueda
pública en Internet sobre el nombre de una persona o la función de lectura en
voz alta; las utilizamos únicamente mediante una acción individual deliberada.
[Opcional — suprimir si no se utiliza: Para la redacción de escritos procesales
utilizamos además un espacio de trabajo de IA en el que los datos del
expediente se tratan sin sustitución por marcadores; este canal se emplea
exclusivamente bajo nuestra supervisión directa.] Con independencia de las funciones de IA,
el software envía las direcciones postales almacenadas en nuestros registros — sin nombres — al servicio
público de mapas OpenStreetMap para poder mostrarlas en un mapa.
El proveedor. Según las condiciones del proveedor que nos son
aplicables, los contenidos transmitidos a través de la API
no se utilizan para entrenar modelos de IA y solo se conservan durante un
periodo limitado. El tratamiento puede tener lugar fuera del Espacio Económico
Europeo; en tal caso, la transferencia está protegida por las garantías
acordadas en nuestro contrato de encargo. Lo que el proveedor puede hacer con
los datos lo rige dicho contrato, no el criterio de la IA.
Su elección. Nuestro secreto profesional permanece intacto: más allá
de lo aquí descrito, ningún dato sale del despacho. El tratamiento se basa en
el mandato que nos ha conferido y en nuestro interés legítimo en una gestión
eficiente y rigurosa de su expediente. Puede oponerse en cualquier momento al
uso de las funciones asistidas por IA; en la medida de lo posible, tramitaremos
entonces su expediente sin ellas. Conserva además todos sus derechos en materia
de protección de datos: acceso, rectificación, supresión y reclamación ante la
autoridad de control.
La presente declaración se ha derivado del código fuente de la aplicación
(seudonimizador, router externo, registro de auditoría y la vía de transmisión de cada
función) y refleja el comportamiento entregado de la versión 1.0.7 (a noviembre de 2026). El tratamiento por parte
del propio proveedor de IA — conservación, uso para entrenamiento, subencargados, jurisdicción —
se rige exclusivamente por las condiciones del proveedor, en sus versiones vigentes. Los
enlaces a las condiciones y a la política de privacidad de cada proveedor figuran también en la sección
correspondiente de la configuración de IA.